Meus Projetos
1.
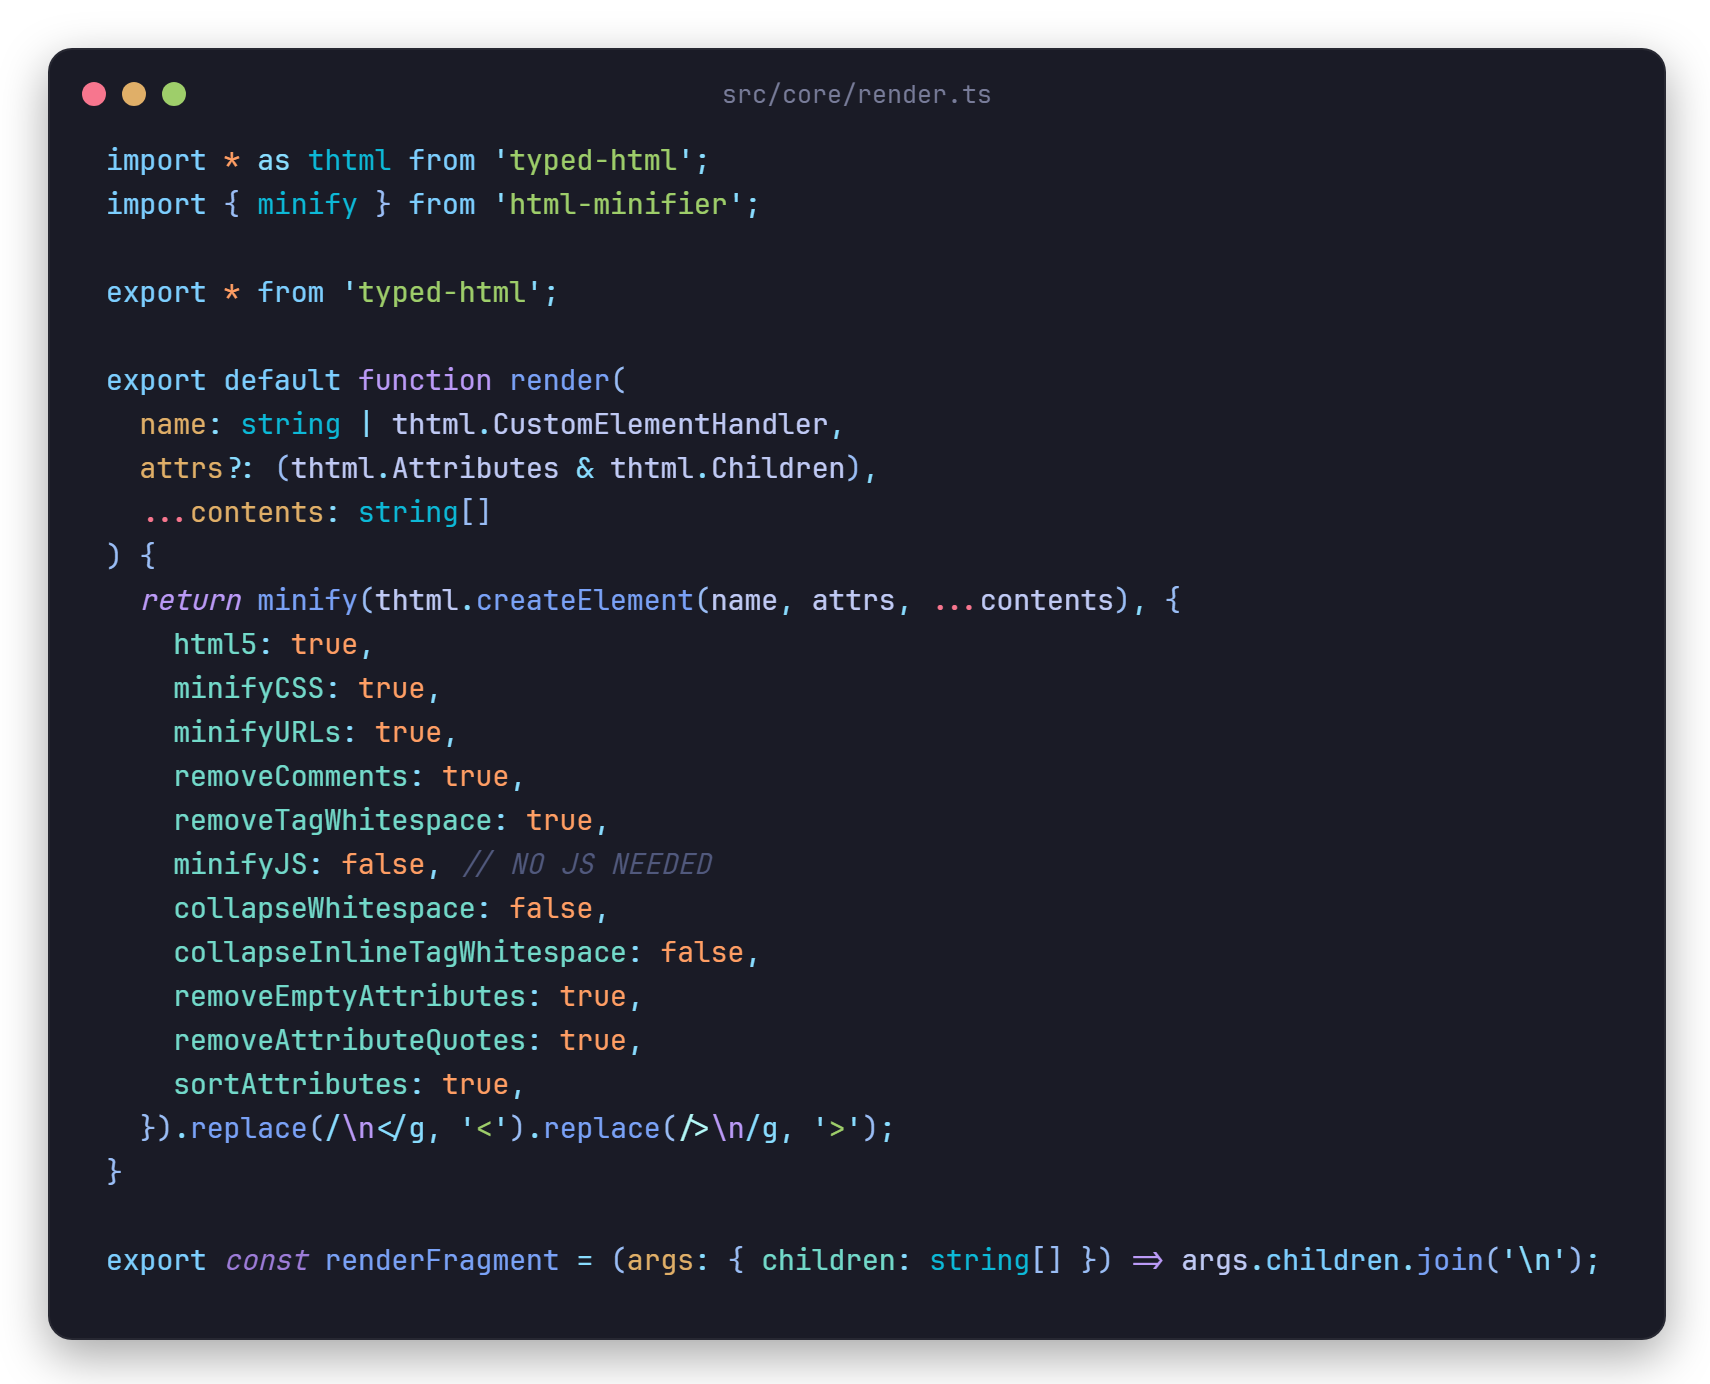
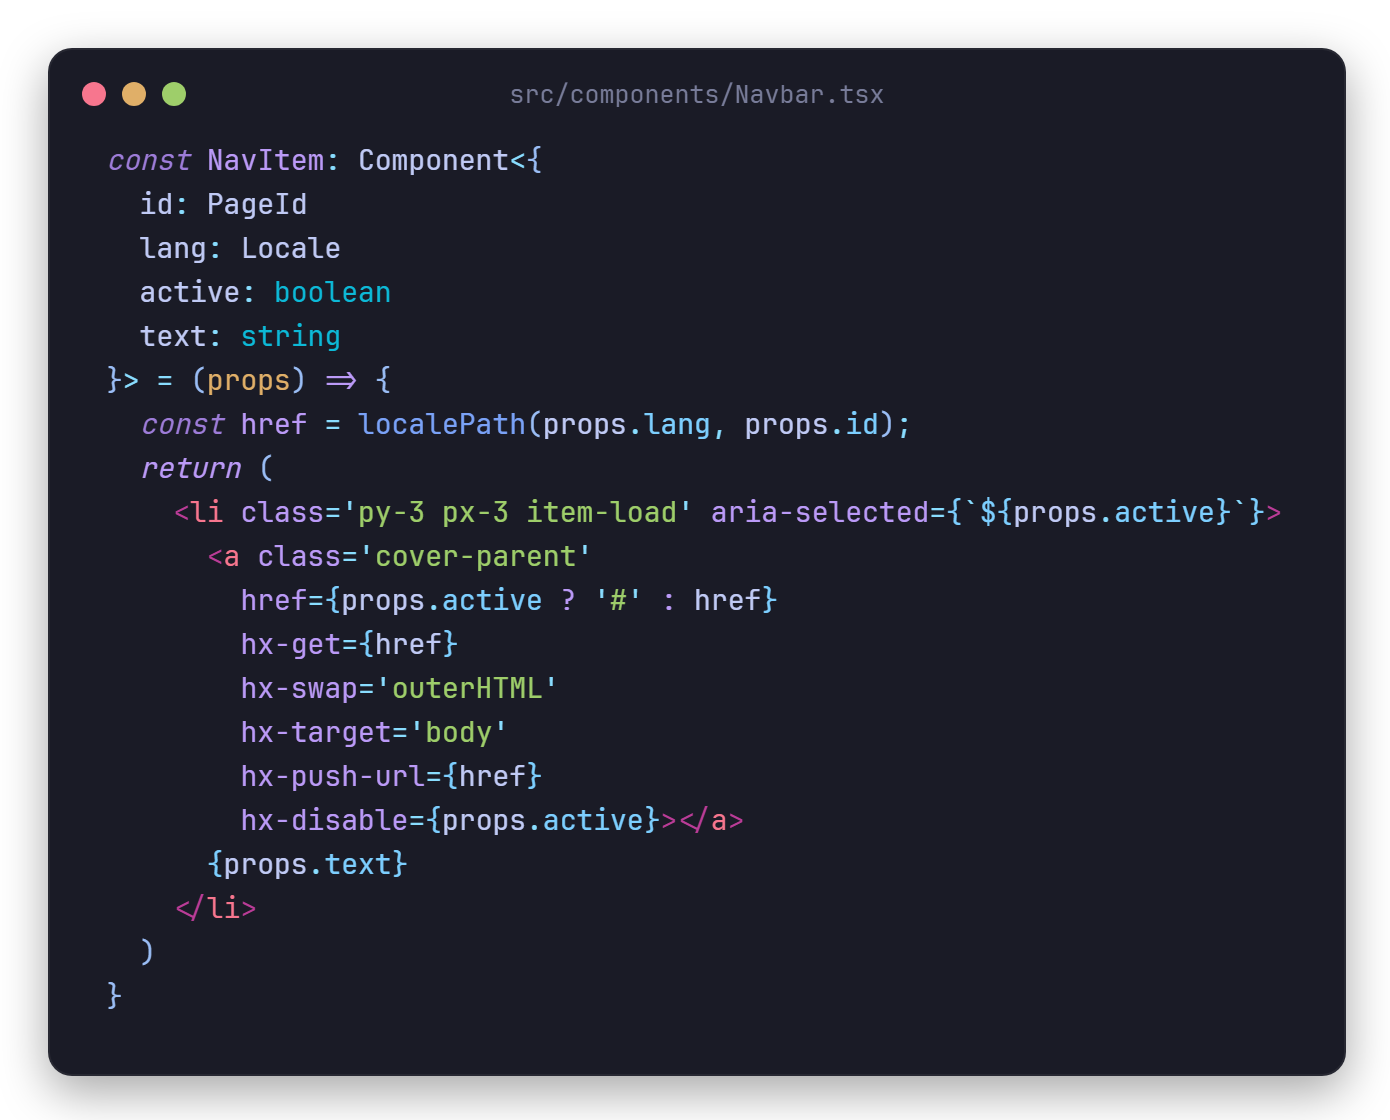
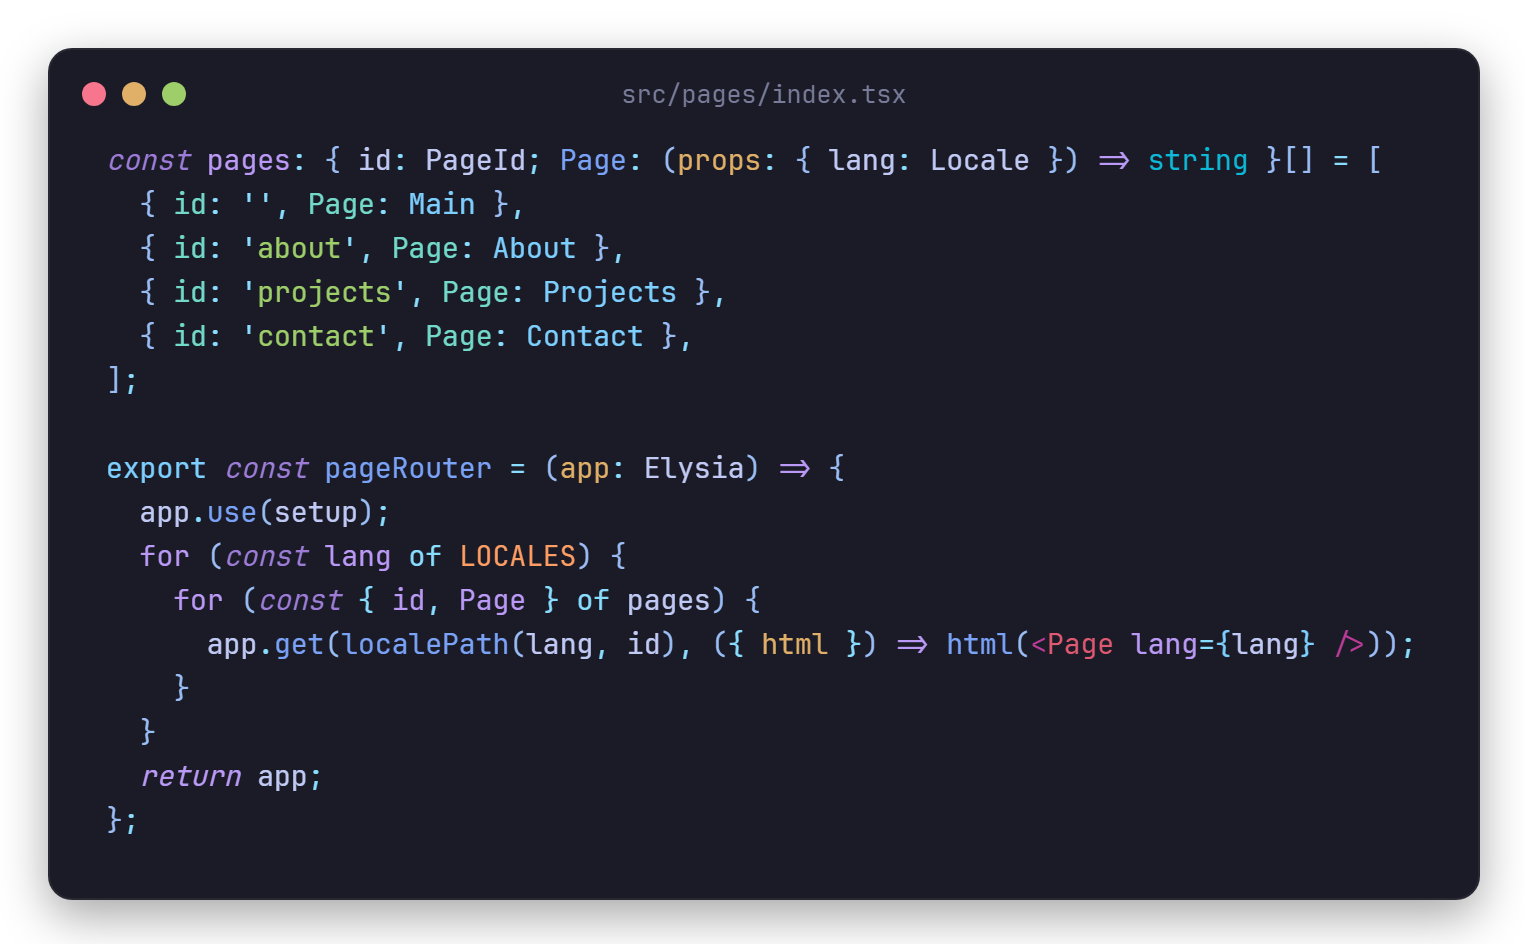
Este portfólio é um projeto em puro TypeScript. Não foi usado nenhum framework de front-end. É um projeto full-stack server-based que usa Elysia.js, o renderizador de HTML do framework e HTMX para interações no front-end.
No tempo que você chegou aqui, você não deve ter recebido nem 80 kilobytes de JavaScript!
Toda a interatividade e simulação de Single Page App é feita através do mecanismo de swap do HTMX, que através dos parâmetros coletados na página, aciona o servidor Elysia para renderizar o HTML e transferir os conteúdos das páginas de forma completa.
Em comparação: enquanto você carrega um site feito em React baixando no mínimo 2 megabytes de JavaScript (esse é o Bundle), no site deste portfólio você baixa apenas 50 kilobytes, vindo do HTMX.
Além da otimização, o developer experience é comparável ao mesmo do desenvolvimento em React visto que é utilizado JSX, porém numa abordagem mais simplista que evita todo bloat do React ou de frameworks front-end.
2.
cli-authenticator é um autenticador TOTP (2FA) para o terminal, feito em Node.js puro. Os códigos aparecem assim que o CLI abre, e novas contas entram por um print de QR code, por arquivo ou pela câmera, inclusive as exportações do Google Authenticator, que chegam divididas em vários QR codes.
O foco foi segurança: os segredos ficam num cofre criptografado com AES-256-GCM, com a chave derivada da senha mestra via scrypt e nunca salva em disco. Tudo que entra é tratado como entrada não confiável: arquivos legados são lidos como texto (nunca executados), nomes vindos de QR codes são sanitizados contra injeção de sequências de escape no terminal, e códigos copiados ficam fora do histórico da área de transferência.
A interface é desenhada só com sequências ANSI, sem framework de TUI, inclusive o preview da câmera, renderizado com meio-blocos Unicode. A leitura dos QR codes usa o ZXing compilado para WebAssembly, rodando localmente, e a câmera é acessada via ffmpeg no Windows, macOS e Linux.
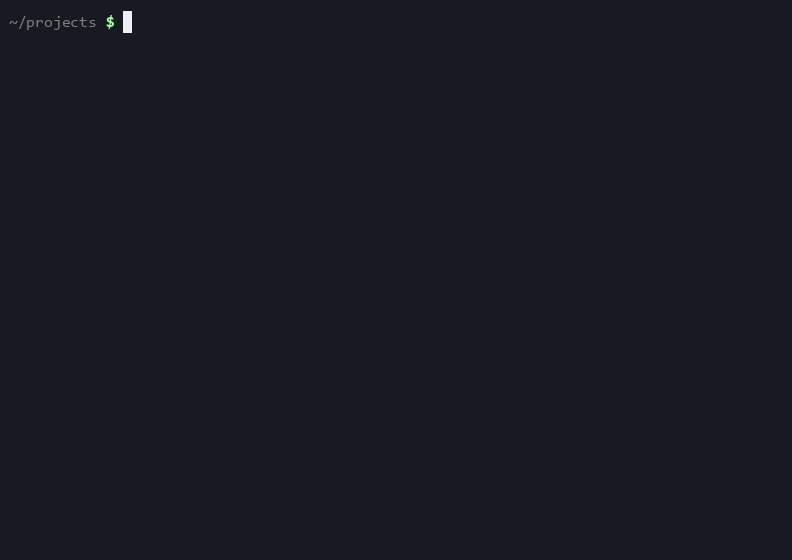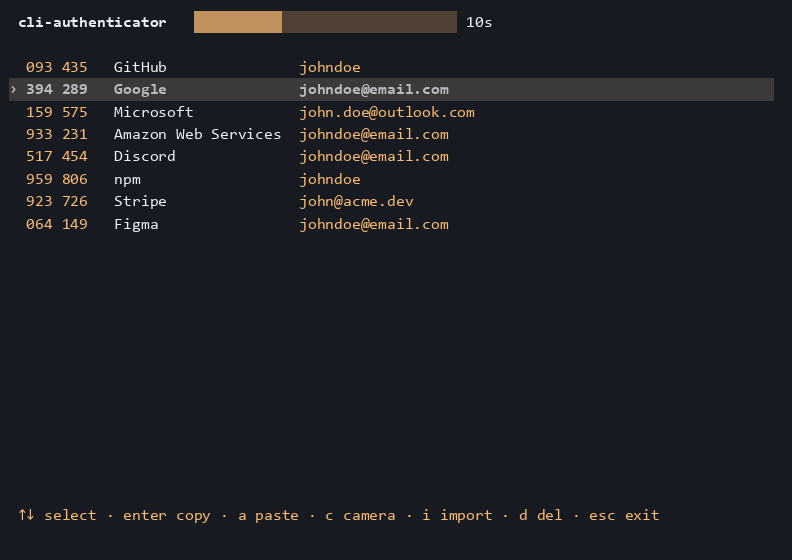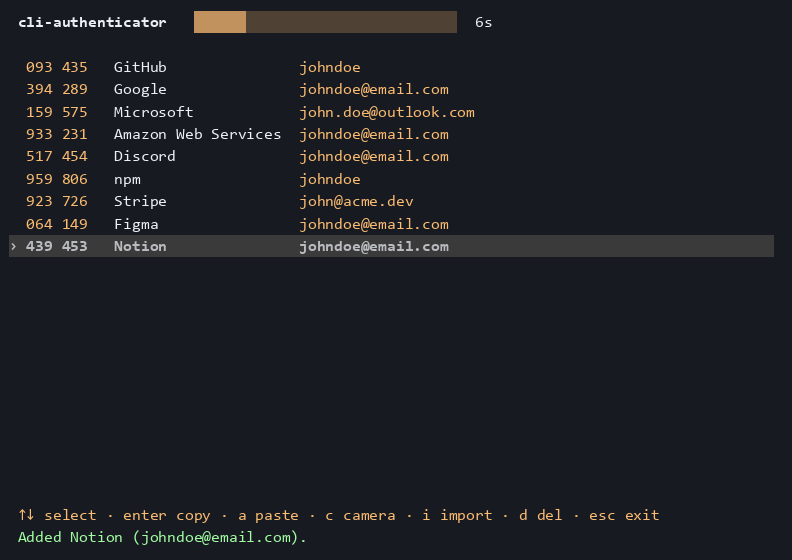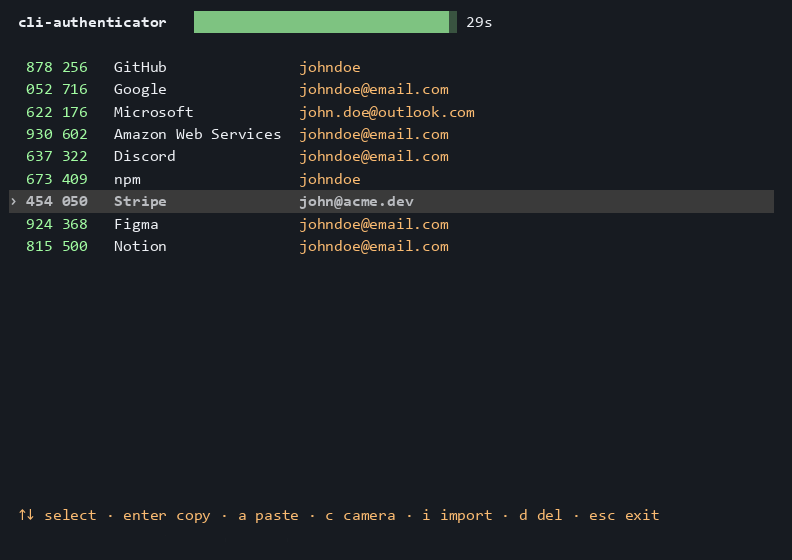
Contas e códigos fictícios, gerados para a demonstração.
3.
Gerenciador de Múltiplos Agentes de Conversação Fluida é uma plataforma para criar agentes de conversação treinados no seu próprio conteúdo, integrada a múltiplas LLMs e escrita em Elixir, com Phoenix e OTP. É o projeto que une meus conhecimentos de back-end e IA, e uma versão mais simples do sistema de gerência e deploy de chatbots que desenvolvi para a Elife.
A arquitetura é orientada a eventos: tudo que acontece no sistema (uma mensagem respondida, uma chamada de modelo, o progresso de um treinamento) vira um evento no PubSub do Phoenix. Persistência, contabilização de tokens, webhooks e um canal ao vivo por WebSocket são assinantes independentes, e uma falha em um deles não afeta os outros.
Cada conversa roda no seu próprio processo supervisionado: as mensagens de um mesmo usuário são processadas em ordem, usuários diferentes em paralelo, o histórico fica em memória e os avisos de inatividade são timers do próprio processo, sem cron. Se o servidor cai no meio de um treinamento, o coordenador reconstrói a fila a partir do banco ao subir.
Responder e treinar são pipelines componíveis, declarados como uma lista de etapas. Cada etapa pode ser condicional, ter retry, rodar com timeout numa tarefa supervisionada ou em paralelo com outras (a detecção de idioma e a busca semântica rodam ao mesmo tempo), e dá para trocar, inserir ou remover etapas em tempo de execução ou por configuração.
Os modelos são intercambiáveis: cada um é endereçado como provedor:modelo (OpenAI, Anthropic, Gemini ou modelos locais via Ollama), e trocar o modelo de um agente é um único PATCH, inclusive no meio de uma conversa. Cada provedor pode ter rate limiting próprio, com retries que respeitam os limites da API.
O RAG faz busca semântica com embeddings em PostgreSQL com pgvector, e os agentes podem chamar ferramentas locais ou de qualquer servidor MCP (via stdio ou HTTP). A conversa pode ser transferida para um atendente humano quando integrada a um sistema externo, e a suíte de testes roda sem banco nem rede, com armazenamento em memória e um provedor de modelos falso.
Tecnologias: Elixir, Phoenix, PostgreSQL + pgvector, Ollama e MCP.
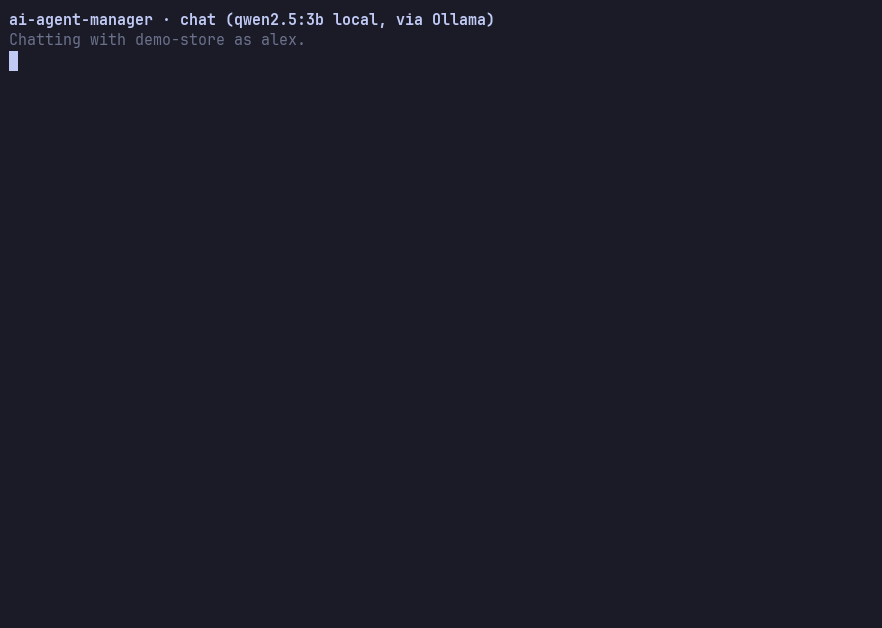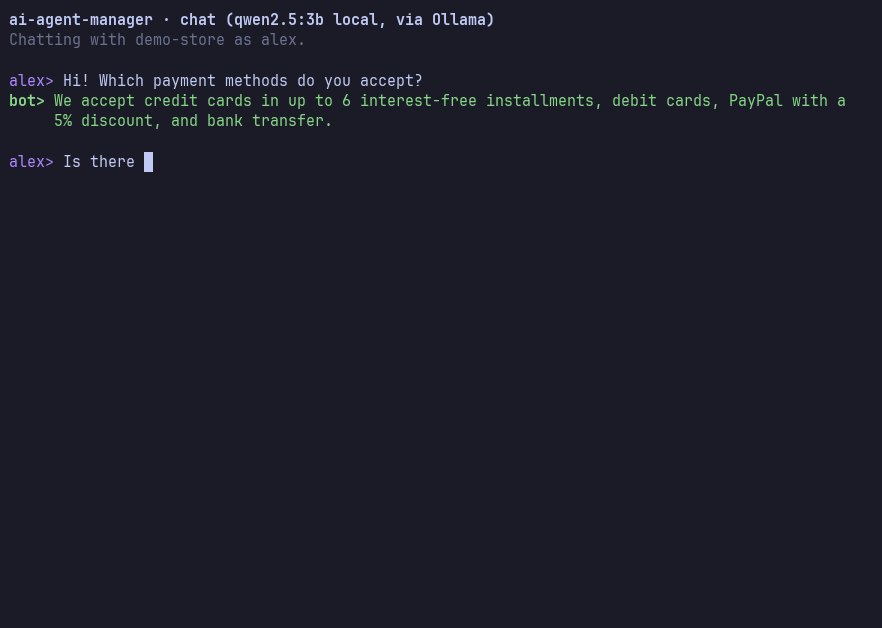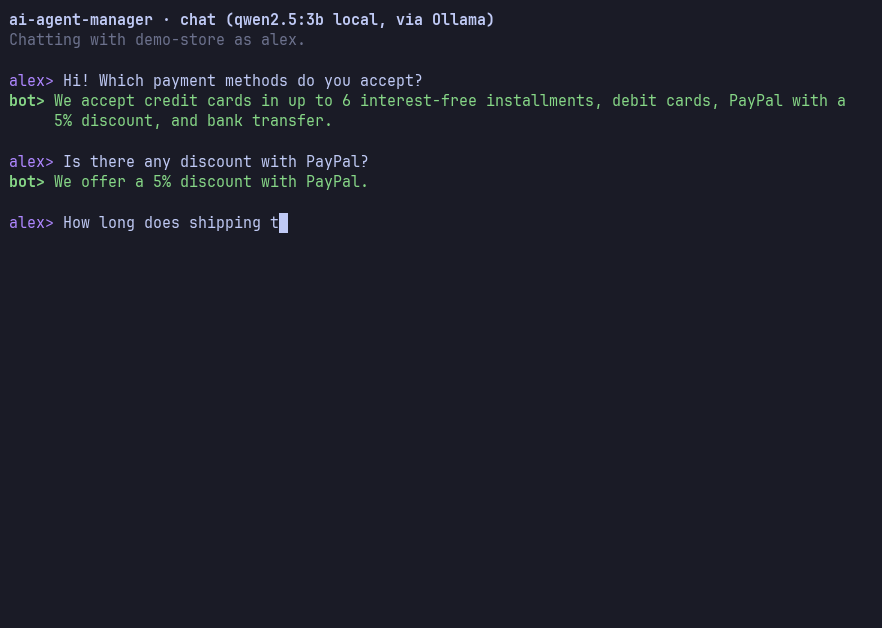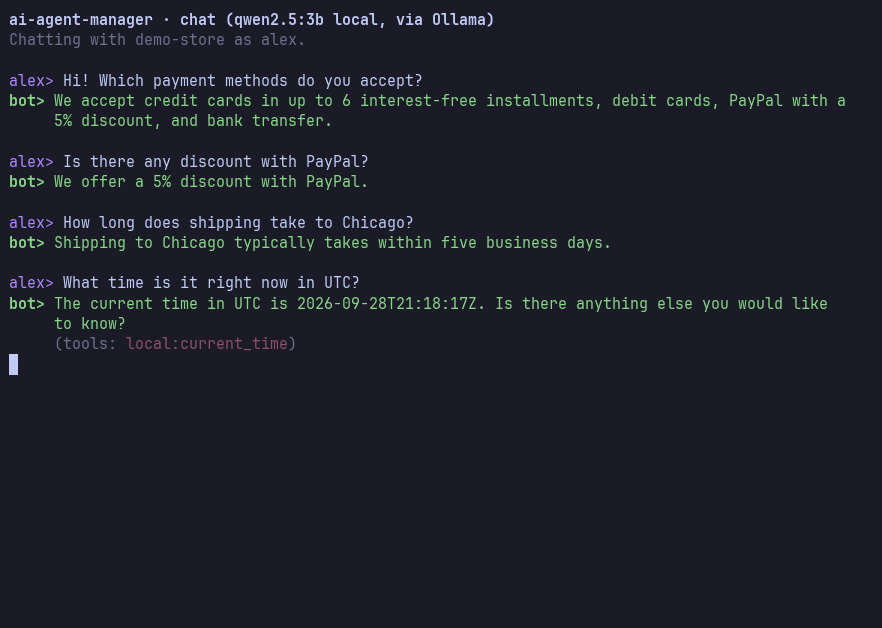
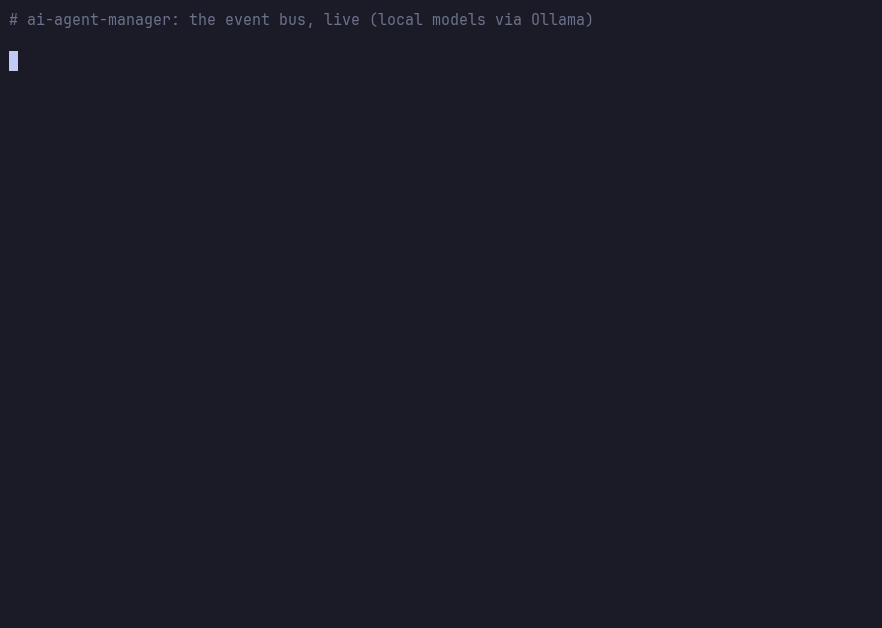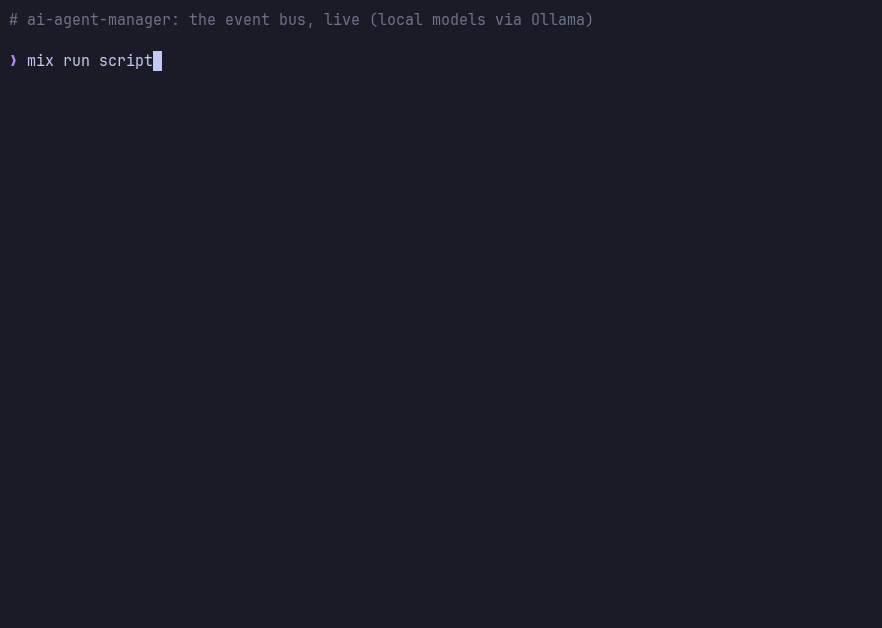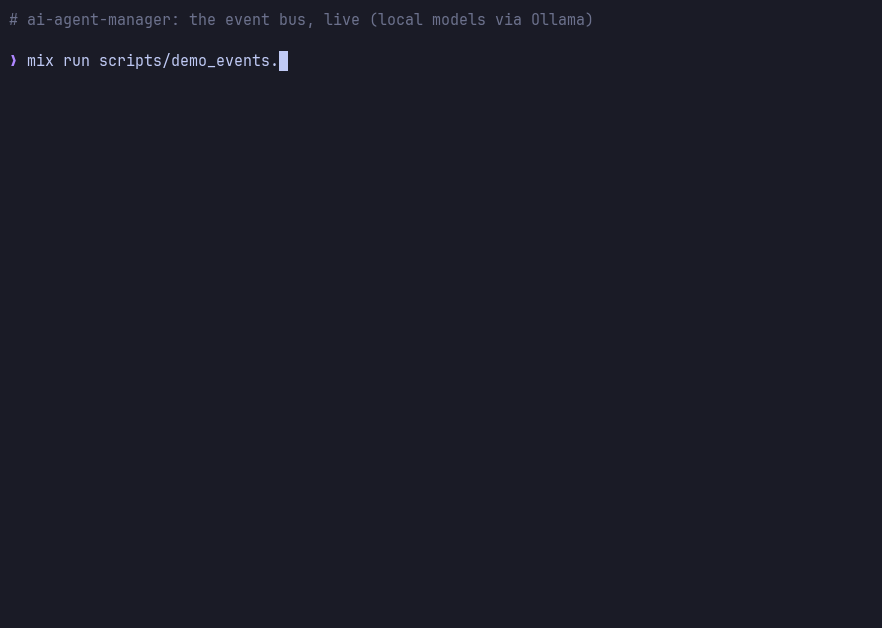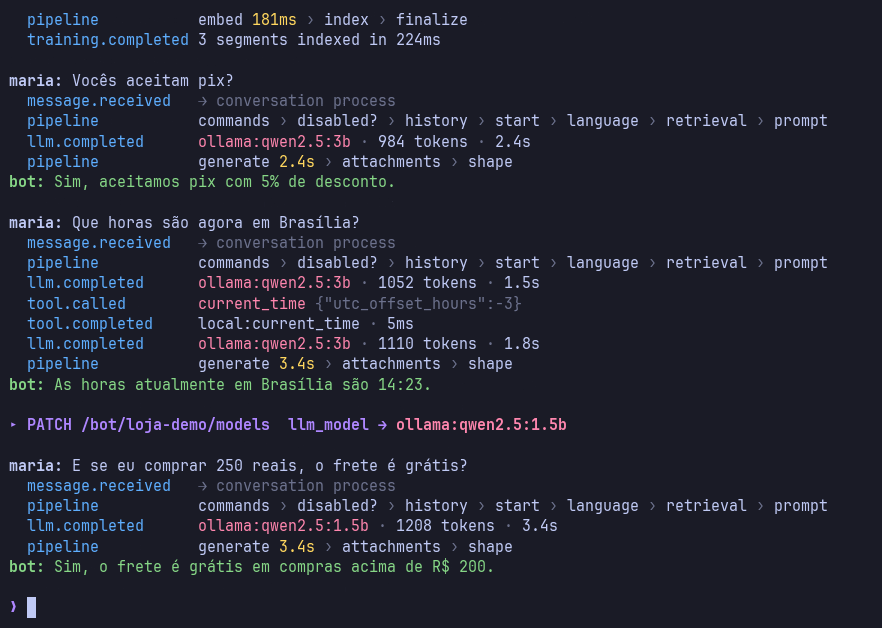
Gravações reais com modelos locais (qwen2.5 e embeddinggemma via Ollama, em CPU); as esperas pelo modelo foram encurtadas.
4.
Sistema de Controle de Protocolos para Administração pública é um projeto que foi fruto de duas bolsas PIBIC-EM e foi finalizado e implantado como fruto do meu trabalho de conclusão de curso no IFPB.
Nesse projeto pude usar meu conhecimento da época que se baseou nas tecnologias mais novas para a linguagem e estruturas de dados. O sistema precisou lidar com alto tráfego e alto desempenho de processamento devido a alta usabilidade do software. Todos os setores da prefeitura/repartição podem se integrar com a ferramenta para tramitar protocolos de forma rápida e eficiente.
O sistema foi desenvolvido usando a stack MERN. MongoDB, Express, Angular e Node.js. Na época do desenvolvimento inicial do software pude trabalhar com a versão inicial do Angular.js (1.8.x, beta-2.x), e foi nesse projeto em que pude me aprimorar bastante na minha formação full-stack, pois foi a primeira vez que desenvolvi front-end e back-end integrados para o mesmo projeto, ao mesmo tempo.
5.
Sistema de Significação Geral de Palavras on-line foi um projeto no qual fui contemplado com bolsa de iniciação científica PIBIC-EM onde o foco era aglomeração de significados linguísticos.
Foi um sistema desenvolvido para pesquisa linguística complexa, que coleta informações de vários sites e organiza num relatório mais enxuto automaticamente para o pesquisador. Também teve a ênfase na facilitação da pesquisa para pesquisadores surdos, utilizando o sistema V-Libras, que transforma o relatório gerado num vídeo de um personagem traduzindo o texto para libras.
Esse projeto foi fundamentalmente um front-end que fazia uma série de rotinas otimizadas de scraping em vários sites. Foi utilizado JavaScript puro para roteamento de páginas e Puppeteer e Cheerio para scraping.
Mais projetos
Vamos conversar sobre meus outros projetos e novos projetos! Você pode encontrar formas de falar comigo na seção Contato.